Als ich angefangen habe, mir einen kleinen Sicherheitsberater zu bauen — ein Werkzeug, das im Interviewformat die eigenen Schwachstellen abfragt und Empfehlungen gibt —, war die erste Entscheidung nicht, welches Modell das klügste ist. Die erste Entscheidung war, dass nichts davon den Rechner verlässt. Wer eine Software baut, der alle Lücken und Zugänge und Umwege kennt, der sollte diese nicht über eine öffentliche Schnittstelle laufen lassen.
Das ist der Moment, in dem die Frage kippt. Vorher fragt man: Welches Modell ist das beste? Danach fragt man: Was passiert mit meinen persönlichsten Daten?
Genau diese Frage bekomme ich fast nie gestellt. Gefragt wird nach den bekannten Namen — welches Modell sollen wir nehmen? Das hängt immer davon ab was man machen möchte.
Warum Bestenlisten die falsche Frage beantworten
Jeden Monat erscheint ein neues Ranking der besten KI-Modelle, und jeden Monat sieht es anders aus. Wer seine Anbieterwahl an Benchmarks aufhängt, trifft eine Entscheidung mit Verfallsdatum.
Es gibt allerdings eine Sorte Liste, die nützlicher ist als die üblichen Fähigkeits-Ranglisten: Das LLM Safety Leaderboard auf Hugging Face bewertet Modelle nicht danach, wie klug sie sind, sondern wie sie sich verhalten. Es beruht auf DecodingTrust, der zugehörige Aufsatz wurde auf der NeurIPS 2023 als Outstanding Paper ausgezeichnet. Bewertet werden acht Perspektiven, jeweils auf 0 bis 100 normiert:
Toxizität · Stereotype und Verzerrung · Robustheit gegen gezielte Angriffe · Robustheit außerhalb der Trainingsverteilung · Privatsphäre · Robustheit gegen manipulierte Beispiele im Prompt · maschinelle Ethik · Fairness
Das ist die interessantere Art zu fragen. „Privatsphäre" misst zum Beispiel, ob ein Modell Trainingsdaten oder Inhalte aus dem laufenden Gespräch ausplaudert — eine Eigenschaft, die in keinem Coding-Benchmark auftaucht und die für den Betrieb hochrelevant ist.
Und trotzdem der wichtige Vorbehalt: Das Leaderboard wurde zuletzt im November 2024 aktualisiert. Die Modelle, die dort stehen, sind zwei Generationen alt. Damit belegt es ungewollt genau den Punkt dieses Artikels — auch gute Listen veralten. Übernehmen Sie die Methode, nicht die Rangfolge.
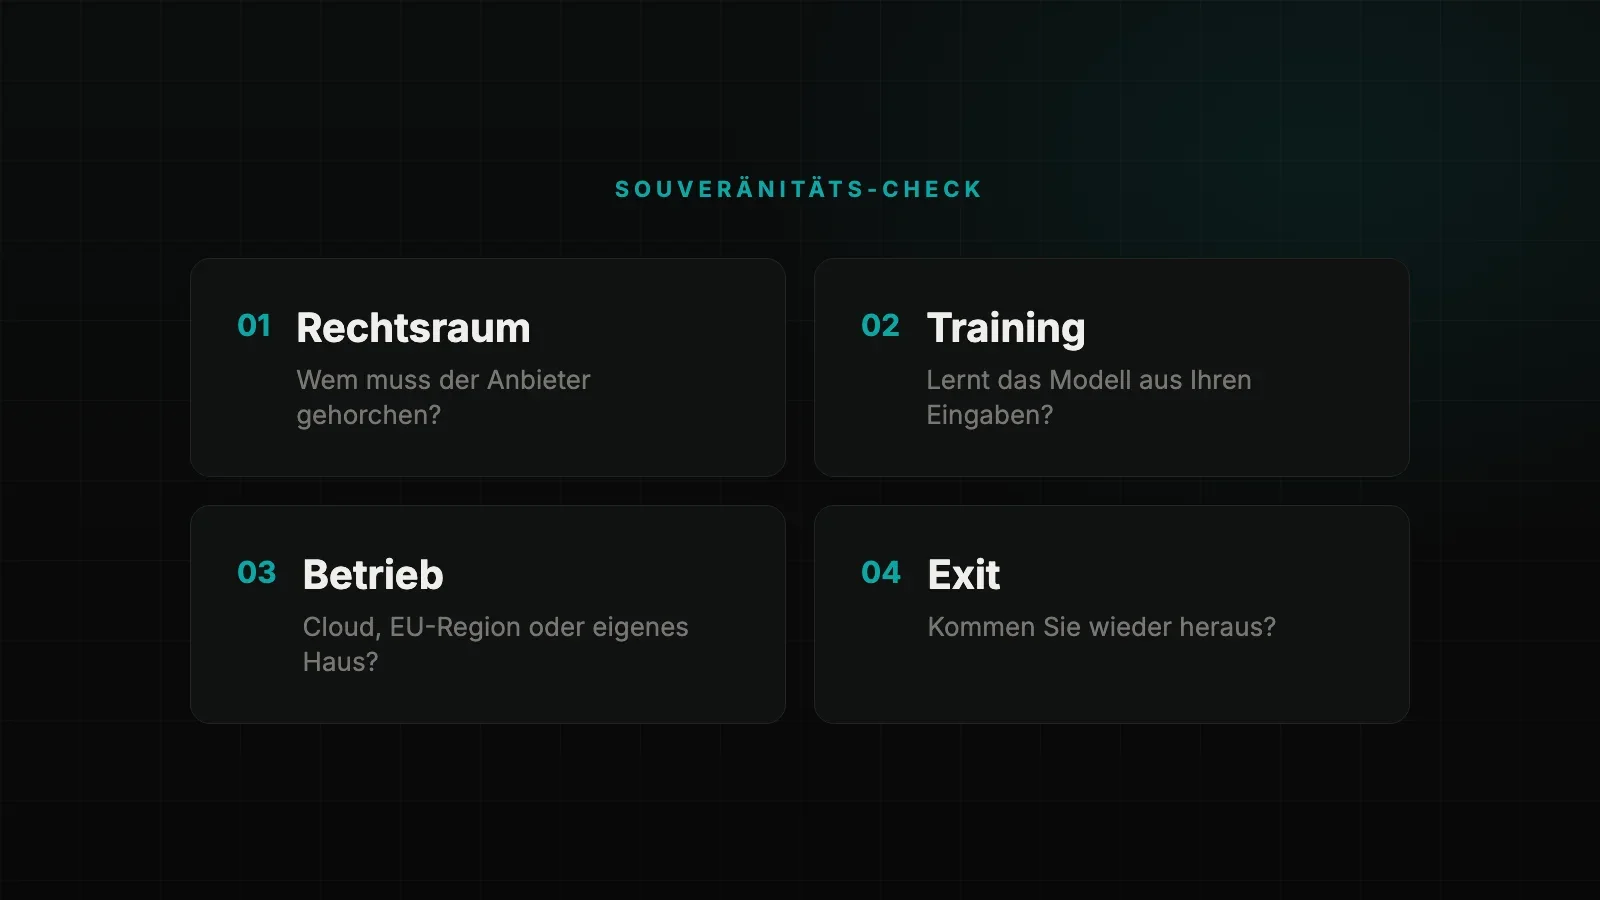
Vier Fragen statt einer Bestenliste
1. In welchem Rechtsraum landet Ihre Eingabe?
OpenAI, Anthropic, Google und Microsoft sind US-Unternehmen. Auch wenn die Verarbeitung in einem europäischen Rechenzentrum stattfindet, unterliegt der Betreiber US-Recht — der CLOUD Act verpflichtet amerikanische Anbieter, Daten auf Anordnung herauszugeben, unabhängig vom Speicherort. Ein EU-Rechenzentrum ist ein Standort, kein Rechtsraum — zum größeren Bild dahinter siehe digitale Souveränität. Europäische Anbieter wie Mistral sind hier anders aufgestellt; prüfen muss man es trotzdem im Einzelfall.
2. Wird mit Ihren Eingaben trainiert?
Hier liegt der größte Unterschied zwischen den Zugangswegen, nicht zwischen den Anbietern. Kostenlose Endkunden-Chatbots behalten sich in der Regel vor, Eingaben zur Verbesserung der Modelle zu nutzen. Bezahlte API- und Unternehmens-Verträge schließen das üblicherweise aus. Wer im Betrieb dieselbe Oberfläche nutzt wie privat, hat meist die falsche Vertragsstufe. Das gehört in jede KI-Richtlinie: Welcher Zugang, welcher Vertrag, welche Datenklassen.
3. Welche Betriebsmodelle bietet der Anbieter an?
Die Spannbreite reicht vom reinen SaaS-Dienst über EU-Datenregionen und Zero-Retention-Vereinbarungen bis zu offenen Modellgewichten, die Sie vollständig selbst betreiben. Je sensibler die Daten, desto weiter sollten Sie auf dieser Skala nach hinten rücken.
4. Wie kommen Sie wieder heraus?
Exportierbare Daten, dokumentierte Schnittstellen, keine proprietären Formate im Kern der eigenen Prozesse. Wer seine Arbeitsabläufe tief mit einem einzelnen Anbieter verzahnt, hat bei der nächsten Preiserhöhung keine Verhandlungsposition. Ein Systemwechsel muss möglich bleiben, sonst war die Auswahl keine Entscheidung, sondern ein Beitritt.
Was bei chinesischen Modellen anders ist
DeepSeek und Qwen sind gut, günstig und offen verfügbar. Sie zu ignorieren, wäre albern. Sie unbesehen einzusetzen, ebenfalls. Wichtig ist, zwei Dinge auseinanderzuhalten, die fast immer vermischt werden: den Dienst und die Gewichte.
Der Dienst: eine eindeutige Sache
Wer die gehostete DeepSeek-App oder deren API nutzt, schickt Eingaben, Chatverläufe und Standortdaten nach China. Das ist keine Vermutung, sondern behördlich festgestellt: Die italienische Datenschutzbehörde ließ DeepSeek im Januar 2025 aus den dortigen App-Stores entfernen. Die Berliner Datenschutzbeauftragte Meike Kamp meldete die App im Juni 2025 bei Apple und Google als rechtswidrigen Inhalt — mit der Begründung, DeepSeek habe nicht überzeugend darlegen können, dass Daten deutscher Nutzer in China auf EU-Niveau geschützt sind. Behörden in Südkorea, Taiwan und Australien gingen ebenfalls vor.
Für Frage 1 ist die Antwort damit erledigt. Für betriebliche Daten kommt der gehostete Dienst nicht in Betracht.
Die Gewichte: die unterschätzte Hälfte
Interessanter — und deutlich seltener verstanden — ist der zweite Teil. Man hört oft: „Wir betreiben DeepSeek einfach lokal, dann ist das Datenproblem gelöst." Das stimmt. Nur löst es das andere Problem nicht.
Die Ausrichtung des Modells steckt in den Gewichten, nicht erst im Filter davor. Die Untersuchung R1dacted hat die offen veröffentlichten R1-Gewichte und deren destillierte Varianten geprüft und findet die Zensur dort wieder — nicht nur in der App. Ein lokal laufendes DeepSeek beantwortet Fragen zu den Kent-State-Schüssen in den USA und verweigert die Auskunft zum Tiananmen-Platz 1989. Politisch heikle Themen — Tiananmen, der Status Taiwans, die Uiguren — werden in einem Großteil der Fälle abgelehnt oder umschifft, unabhängig davon, ob man über die API oder lokal zugreift.
Für die meisten Firmen ist das kein politisches, sondern ein betriebliches Problem. Ein Modell, das gelernt hat, bestimmte Dinge auszulassen, lässt sie auch in Ihrer Risikoanalyse aus. In der Marktbetrachtung zu einem chinesischen Wettbewerber. In der Lieferantenprüfung. Sie merken es nicht, weil eine Auslassung keine Fehlermeldung erzeugt.
Fairnesshalber: Kein Modell ist neutral. Westliche Modelle haben ebenfalls eine antrainierte Ausrichtung, nur eine andere. Der Unterschied liegt nicht darin, ob Kanten existieren, sondern ob Sie wissen, wo sie liegen — und ob Sie sie für Ihren Anwendungsfall testen können. Genau deshalb ist die Verhaltensmessung aus dem Abschnitt oben mehr wert als jede Fähigkeits-Rangliste.
Offene Gewichte lokal: was sie können und wo die Gefahren liegen
Wie man ein Modell auf dem eigenen Rechner betreibt, habe ich an anderer Stelle beschrieben. Kurz gefasst: Für Zusammenfassungen, Entwürfe, Erklärungen und Verständnisarbeit reichen offene Modelle im Alltag aus. An der Spitze bleibt der Abstand zu den kommerziellen Modellen sichtbar.
Die Gefahren liegen woanders, als die meisten vermuten.
„Offene Gewichte" ist nicht „Open Source". Sie bekommen die Gewichte, nicht die Trainingsdaten. Sie können das Modell betreiben und anpassen — aber Sie können nicht nachsehen, was hineingeflossen ist. Prüfen lässt sich nur das Verhalten, nie die Herkunft. Dazu kommen Lizenzen, die den Namen „offen" nur teilweise verdienen: Llama etwa hat Nutzungsbeschränkungen, die eine echte Open-Source-Lizenz nicht hätte.
Die Lieferkette ist eine echte Angriffsfläche. Modelle werden von öffentlichen Plattformen geladen. Dort stehen neben den Originalen unzählige Ableger, „unzensierte" Varianten und Namen, die sich um einen Buchstaben unterscheiden. Laden Sie aus der offiziellen Quelle des Herausgebers, bevorzugen Sie das safetensors-Format gegenüber älteren Python-Formaten, die beim Laden Code ausführen können, und behandeln Sie ein Modell wie jede andere fremde Software: Herkunft dokumentieren, Version festschreiben.
Ab jetzt patchen Sie selbst. Ein Cloud-Anbieter aktualisiert sein Modell, wenn eine Schwäche bekannt wird. Ihr lokales Modell bleibt so, wie Sie es heruntergeladen haben — mitsamt allem, was später daran gefunden wird.
Lokal heißt nicht sicher. Ein Modell auf einem ungepflegten Rechner ohne Festplattenverschlüsselung, ohne Backup, mit offenem Netzwerkdienst ist schlechter aufgestellt als ein ordentlicher Vertrag mit einem europäischen Anbieter. Der Souveränitätsgewinn ist nur so viel wert wie der Betrieb dahinter. Das ist keine Kleinigkeit: Sie übernehmen damit die Rolle, die vorher der Anbieter hatte — mitsamt Verantwortung.
Vermittler wie OpenRouter
OpenRouter ist ein Zwischenhändler: ein Schlüssel, eine Schnittstelle, dahinter Dutzende Modelle verschiedener Anbieter. Der Wechsel von einem Modell zum anderen ist eine geänderte Zeichenkette im Code.
Für Frage 4 ist das die beste Antwort am Markt. Kein Lock-in, direkter Preisvergleich, Ausweichmöglichkeit wenn ein Anbieter ausfällt, und der Test eines neuen Modells kostet Minuten statt eines neuen Vertrags. Für Prototypen und für alles, wo Sie sich noch nicht festlegen wollen, ist das genau richtig.
Für Frage 1 machen Sie es sich schwerer. Ihre Eingabe geht jetzt über eine Station mehr: von Ihnen zu OpenRouter — einem US-Unternehmen — und von dort zum eigentlichen Anbieter. Zwei Rechtsräume statt einem, zwei Verträge statt einem.
Was man dazu wissen sollte:
- OpenRouter selbst speichert Inhalte von Anfragen und Antworten nicht, solange Sie die Protokollierung nicht ausdrücklich einschalten. Wenn Sie sie einschalten, räumen Sie OpenRouter ein unwiderrufliches Recht zur kommerziellen Nutzung dieser Ein- und Ausgaben ein. Diese Zeile sollte man gelesen haben.
- Metadaten — Tokenzahl, Laufzeit, Modell, Kosten — werden in jedem Fall gespeichert.
- Ob der dahinterliegende Anbieter protokolliert oder trainiert, richtet sich nach dessen eigener Richtlinie, nicht nach OpenRouters. OpenRouter weist die Richtlinie je Endpunkt aus.
- In den Kontoeinstellungen lässt sich das Routing zu Anbietern, die auf Ihren Daten trainieren dürfen, abschalten — getrennt für bezahlte und kostenlose Modelle.
- Es gibt eine Zero-Data-Retention-Einstellung, die Anfragen ausschließlich an Endpunkte leitet, die nichts speichern; wer nichts speichert, kann darauf auch nicht trainieren. Durchsetzbar kontoweit, je Modellgruppe oder einzeln pro Anfrage über den Parameter
zdr.
Mein Urteil: Für Prototypen uneingeschränkt. Für Interna vertretbar, aber nur mit erzwungenem Zero-Data-Retention und abgeschaltetem Training-Routing — und das gehört dokumentiert, nicht einmal angeklickt. Für das Herzstück nicht. Ein Vermittler löst das Bindungsproblem, er löst kein Vertraulichkeitsproblem.
Meine Faustregel für die Praxis
Nicht der Anbieter ist die erste Entscheidung, sondern die Datenklasse:
| Datenklasse | Beispiele | Was infrage kommt |
|---|---|---|
| Öffentlich und unkritisch | Recherche, Textentwürfe ohne Interna | Jeder große Anbieter, gern über einen Vermittler. Die Qualität entscheidet. |
| Interna | Strategie, Verträge, Personalthemen | Nur mit Unternehmensvertrag, ausgeschlossenem Training und geklärtem Rechtsraum. Vermittler nur mit erzwungenem Zero-Data-Retention. |
| Das Herzstück | Mandanten- und Patientendaten, Betriebsgeheimnisse, alles unter Berufsgeheimnis | Gehört nicht in fremde Hände. Ein lokal betriebenes offenes Modell ist die sauberste Antwort — vorausgesetzt, der Rechner dahinter ist ordentlich betrieben. |
Diese Einteilung überlebt jede Modellgeneration. Welcher Anbieter gerade den Benchmark anführt, ist dann die letzte Frage — und die am wenigsten wichtige.
Und die eine Prüfung, die ich jedem empfehle, kostet nichts: Nehmen Sie eine echte, aber unkritische Aufgabe aus Ihrem Haus und stellen Sie sie drei Modellen. Nicht um zu sehen, welches gewinnt. Sondern um zu sehen, wo sie sich unterscheiden — und ob eines davon still etwas weglässt.